Note de preuves · The Digital Palaver
Apprendre à la machine les langues de l’Afrique
L’écart se mesure dans les données, et les données se construisent
Les constats
L’Afrique compte 2 213 des 7 685 langues parlées recensées par Glottolog ; dans la région Afrique de l’UIT, 36 % de la population utilise Internet en 2025.
En octobre 2026, trente langues africaines réunissent 0,053 % des pages de Common Crawl, l’anglais 42,56 %.
Dans l’évaluation AfroBench de 2025, les quatre meilleurs modèles fermés cèdent de 13,2 à 19,8 points dans les langues africaines, un modèle ouvert jusqu’à 40,1.
Le kinyarwanda compte plus d’heures de voix validées que le français dans Common Voice ; le haoussa en compte 4,35.
L’Union africaine et l’UNESCO demandent une intelligence artificielle au service des langues africaines ; budgets et archives restent à bâtir.
Une intelligence artificielle réussit dans une langue africaine largement à la mesure des textes et des voix que cette langue a déjà versés en ligne. L’écart avec l’anglais se lit donc dans une archive. Or une archive se construit : des communautés de locuteurs, des chercheurs et des fondations le démontrent depuis 2020. Cette note rassemble les preuves ouvertes, publiées pour l’essentiel de 2024 à 2026, et en tire cinq décisions, pour les pouvoirs publics comme pour les jeunes.
Les prochains utilisateurs parleront leurs langues
Les Africains qui découvriront l’intelligence artificielle dans les années qui viennent l’aborderont d’abord dans leurs propres langues. Ces langues sont nombreuses. Glottolog, la base ouverte de référence des linguistes, recense 7 685 langues parlées comme langue première dans le monde, dont 2 213 dans sa macro-aire Afrique.1 Plusieurs réunissent des dizaines de millions de locuteurs, du lingala (40 millions) à l’amharique (57 millions) et au haoussa (77 millions) ; pour le swahili, les estimations vont de 71 millions à « plus de 200 millions ».2
Les Africains qui découvriront l’intelligence artificielle dans les années qui viennent l’aborderont d’abord dans leurs propres langues.
Ces locuteurs se connectent vite, et de façon très inégale. Selon l’Union internationale des télécommunications (UIT), 66 % des habitants de sa région Afrique âgés de 10 ans et plus possédaient un téléphone mobile en 2024. En 2025, 36 % de la population de la région utilise Internet, quand la moyenne mondiale atteint 74 %.3 Pays par pays (figure 1), l’usage va de 6,7 % au Soudan du Sud en 2019 à 91,2 % au Maroc en 2024, et 35 pays sur 54 restent sous la moitié de leur population.
Figure 1
Dans 35 pays africains sur 54, moins de la moitié de la population utilise Internet
Part de la population qui a utilisé Internet au cours des trois derniers mois, en %, dernière année disponible (2024 pour 51 pays, 2017 à 2020 pour le Soudan, le Soudan du Sud et l’Érythrée)
| Pays | Valeur |
|---|---|
| Maroc | 91,2 |
| Seychelles | 87,8 |
| Libye | 82,0 |
| Afrique du Sud | 78,4 |
| Algérie | 77,4 |
| Tunisie | 76,5 |
| Cabo Verde | 74,7 |
| Égypte | 74,6 |
| Maurice | 73,3 |
| Ghana | 72,2 |
| Gabon | 68,7 |
| Djibouti | 65,3 |
| Namibie | 64,9 |
| Eswatini | 63,4 |
| Guinée équatoriale | 63,3 |
| Sénégal | 60,1 |
| Sao Tomé-et-Principe | 59,1 |
| Botswana | 57,5 |
| Lesotho | 51,8 |
| Gambie | 49,5 |
| Congo | 47,3 |
| Cameroun | 46,3 |
| Mauritanie | 45,8 |
| Zimbabwe | 41,6 |
| Côte d’Ivoire | 41,4 |
| Nigéria | 41,2 |
| Angola | 40,7 |
| Togo | 39,5 |
| Mali | 36,8 |
| Kenya | 35,0 |
| Bénin | 34,0 |
| Guinée | 33,3 |
| Comores | 32,5 |
| Libéria | 32,2 |
| Rwanda | 31,7 |
| Tanzanie | 31,2 |
| Guinée‑Bissau | 29,8 |
| Burkina Faso | 28,3 |
| Somalie | 27,9 |
| Sierra Leone | 25,1 |
| Éthiopie | 21,9 |
| Mozambique | 20,5 |
| RD Congo | 19,7 |
| Malawi | 19,0 |
| Madagascar | 18,7 |
| Soudan | 18,6 |
| Zambie | 17,1 |
| Niger | 15,6 |
| Érythrée | 14,3 |
| Centrafrique | 13,8 |
| Tchad | 12,6 |
| Ouganda | 8,9 |
| Burundi | 8,6 |
| Soudan du Sud | 6,7 |
Lecture : Une case par pays, plus la teinte est soutenue, plus l’usage est élevé ; le Nigéria atteint 41,2 % en 2024, l’Éthiopie 21,9 %, le Kenya 35,0 %.
Source : UIT, World Telecommunication/ICT Indicators Database, via la Banque mondiale, World Development Indicators (mise à jour du 11 novembre 2026) · data.worldbank.org/indicator/IT.NET.USER.ZS
Deux écarts désignent les prochains internautes. Les jeunes ouvrent la marche : en 2024, 53 % des 15-24 ans de la région utilisaient Internet, contre 34 % du reste de la population. Le continent est jeune, avec un âge médian de 19,0 ans en 2023. Les campagnes suivent à distance, avec 23 % de ruraux en ligne pour 57 % de citadins.4
L’objection la plus sérieuse tient en une phrase : les Africains connectés lisent et écrivent déjà l’anglais, le français, l’arabe ou le portugais, et les services numériques peuvent s’en contenter. Elle décrit bien la minorité aujourd’hui en ligne. Elle décrit mal celles et ceux qui la rejoindront. Selon une estimation que cite l’UNESCO, jusqu’à 40 % de la population mondiale reste à l’écart d’un enseignement dans une langue qu’elle parle ou comprend. La difficulté culmine là où la diversité linguistique est la plus forte, en Afrique subsaharienne comme en Asie‑Pacifique.5
La radio montre l’autre versant. Premier média d’information du continent, elle informe chaque jour ou plusieurs fois par semaine 59 % des citoyens de 38 pays enquêtés en 2024-2025. Elle atteint mieux que tout autre média les femmes, les ruraux, les plus pauvres et les moins scolarisés ; chez les 18-35 ans, les réseaux sociaux la devancent déjà, avec 58 % contre 55 %.6 Nous y voyons une leçon pour les assistants vocaux. Une technique qui demande seulement d’écouter et de parler rejoint celles et ceux que l’écrit tient à distance, à condition de parler leur langue.
Le Web qui nourrit les modèles parle d’abord anglais
Un grand modèle de langue apprend ce qu’il lit, et ce qu’il lit vient en grande partie du Web. Le modèle GPT-3, décrit en 2020, tirait 60 % de ses exemples d’entraînement de Common Crawl, une archive publique du Web. Dans son corpus, 93 % des mots étaient anglais.7 Quatre ans plus tard, l’équipe de Meta décrit pour Llama 3 un mélange où les données « multilingues », celles des langues autres que l’anglais, pèsent environ 8 % des jetons.8
Le dernier relevé des langues de Common Crawl, établi sur l’archive d’octobre 2026, mesure ce déséquilibre. Sur 2,17 milliards de pages HTML, l’anglais en occupe 923 millions, soit 42,56 %, et le français 4,76 %. Le swahili, première langue africaine de la liste, réunit 215 652 pages, soit 0,0099 %. Les trente langues africaines que reconnaît le détecteur totalisent 1 148 503 pages, soit 0,053 % de l’archive.9 Pour une page en swahili, l’archive en contient plus de 4 000 en anglais.
0,053 % des pages HTML de l’archive Common Crawl d’octobre 2026 relèvent des trente langues africaines reconnues par son détecteur
Common Crawl, archive CC-MAIN-2026-43
Le tableau 1 rassemble ces mesures pour seize langues africaines, et la démographie y explique une part seulement des écarts. Le lingala, parlé par 40 millions de personnes, compte 22 millions de caractères de texte Web dans le corpus MADLAD-400. Le kinyarwanda, quatre fois moins parlé, en compte 749 millions. Le haoussa et le swahili dépassent chacun 120 000 articles de Wikipédia ; l’oromo, langue de 37 millions de personnes, en réunit 1 972. L’anglais écrase l’ensemble : 9 000 milliards de caractères dans MADLAD-400, plus de 14 000 fois le volume du haoussa.
Tableau 1
Les quatre scores les plus faibles reviennent à des langues qui comptent moins de 50 millions de caractères de texte Web
| Langue | Locuteurs, millions | Texte Web, millions de caractères | Articles Wikipédia | Pages Common Crawl | Score de GPT-4o (AfriMMLU) |
|---|---|---|---|---|---|
| Swahili | 71-106 | 2 400 | 134 816 | 215 652 | 77,4 |
| Kinyarwanda | 10 | 749 | 11 273 | 71 437 | 64,2 |
| Haoussa | 77 | 630 | 121 976 | 87 352 | 67,2 |
| Amharique | 57 | 509 | 15 751 | 90 407 | 59,8 |
| Xhosa | 19 | 287 | 2 604 | 22 514 | 70,2 |
| Shona | 11 | 266 | 11 897 | 23 961 | 67,6 |
| Zoulou | 27 | 257 | 13 030 | 35 948 | 68,2 |
| Igbo | 31 | 251 | 49 320 | 35 342 | 67,2 |
| Yoruba | 46 | 239 | 41 371 | 37 545 | 61,2 |
| Sesotho | 13 | 227 | 2 256 | 18 537 | 67,4 |
| Oromo | 37 | 88 | 1 972 | 14 256 | 61 |
| Luganda | 11 | 48 | 5 900 | 8 426 | 52,8 |
| Éwé | 7 | 33 | 1 438 | 33,6 | |
| Twi | 9 | 25 | 4 749 | 6 613 | 43,2 |
| Lingala | 40 | 22 | 5 346 | 12 901 | 61 |
| Wolof | 5 | 5 | 1 736 | 4 708 | 37,8 |
Lecture : Locuteurs de langue première et seconde ; texte Web du corpus MADLAD-400 ; score de GPT-4o aux questions AfriMMLU, sur 100, où le hasard donnerait 25. Le détecteur de Common Crawl reconnaît l’akan, dont le twi fait partie, et laisse l’éwé de côté.
Source : Adelani et al. (2025), IrokoBench, tableaux 3 et 9 ; Wikimedia, statistiques des éditions de Wikipédia, 20 novembre 2026 ; Common Crawl, archive CC-MAIN-2026-43 · aclanthology.org/2025.naacl-long.139
On objecte que le Web reflète l’usage : si le wolof réunit 4 708 pages dans Common Crawl, les wolophones écriraient peu en ligne. La causalité court aussi dans l’autre sens. Une langue que les claviers, les correcteurs et l’école laissent de côté s’écrit moins à l’écran, et le détecteur lui-même reconnaît trente langues africaines sur plus de deux mille. L’archive existe pourtant hors du Web, dans les manuscrits, les journaux et les fonds des radios. La numériser change le compte.
Les modèles réussissent là où les données abondent
Les évaluations publiées en 2025 confirment le lien entre données et performance, langue par langue. IrokoBench, un banc d’essai traduit par des professionnels et conçu par des chercheurs du réseau Masakhane, a soumis seize grands modèles à trois tâches en dix-sept langues africaines.10 Sur les questions de connaissances, appelées AfriMMLU, GPT-4o répond juste à 87,4 % des questions en anglais, à 83,2 % en français, à 77,4 % en swahili et à 33,6 % en éwé. Chaque question propose quatre réponses : en éwé, le modèle dépasse à peine les 25 % du hasard. La dernière colonne du tableau 1 donne les seize langues.
L’ordre des langues suit, dans l’ensemble, celui des données. Les quatre scores les plus faibles reviennent à l’éwé, au wolof, au twi et au luganda. Ces quatre langues comptent parmi les cinq qui disposent de moins de 50 millions de caractères de texte Web. Le swahili, première langue africaine par le volume de texte, obtient le meilleur score africain. Les auteurs relient eux-mêmes les performances les plus basses aux langues qui ont le moins de données en ligne.11 Le lingala rappelle que d’autres facteurs jouent : 22 millions de caractères, et un score de 61,0.
Un second résultat pèse sur l’usage quotidien. La plupart des modèles testés répondent mieux quand une machine traduit d’abord la question en anglais ; GPT-4 Turbo et GPT-4o font partie des rares exceptions. Un service bâti sur ce détour impose une langue intermédiaire et dépend d’un traducteur automatique dont la qualité varie, elle aussi, avec les données.
AfroBench élargit le constat à 64 langues et quinze tâches, avec une version allégée de quatorze langues qui suit les modèles récents (figure 2). Les quatre modèles fermés les mieux classés obtiennent de 79,7 à 85,1 points en anglais et de 62,8 à 67,0 en moyenne dans les langues africaines. Les modèles aux poids ouverts, que des équipes africaines peuvent adapter à leurs langues, montrent des écarts plus dispersés : de 26,9 à 40,1 points pour les trois de la figure, de 10,3 à 33,2 pour les autres, plus petits ou moins forts en anglais.12
Figure 2
Parmi sept modèles, l’écart entre l’anglais et les langues africaines va de 13,2 à 40,1 points
Score moyen de sept tâches, sur 100, en anglais et dans quatorze langues africaines, modèles évalués en 2024 et 2025
| Modèle | Anglais | Moyenne de 14 langues africaines |
|---|---|---|
| GPT-4.1 | 81,0 | 67,0 |
| Gemini 2.0 Flash | 79,7 | 66,5 |
| GPT-4o | 85,1 | 66,0 |
| Gemini 1.5 Pro | 82,6 | 62,8 |
| Gemma 3 27B | 79,5 | 52,6 |
| Gemma 2 27B | 80,6 | 43,5 |
| Llama 3.1 70B | 80,0 | 39,9 |
Lecture : Le cercle creux donne le score en anglais, le point plein la moyenne africaine ; Gemma et Llama sont des modèles aux poids ouverts.
Source : Ojo et al. (2025), AfroBench, Findings of ACL 2025, tableau 8 · aclanthology.org/2025.findings-acl.976
Reste l’argument optimiste : chaque génération de modèles progresse, et la taille finira par combler l’écart. Les chiffres lui donnent en partie raison. Dans les langues africaines, GPT-4.1, publié en avril 2025, dépasse GPT-4o, et Gemma 3 gagne 9,1 points sur Gemma 2. Les auteurs d’AfroBench notent eux-mêmes ce progrès, qu’ils jugent limité sur les tâches de connaissances.13
La taille aide. L’attention portée à chaque langue décide.
Les langues que la traduction automatique a gagnées l’ont été par des efforts ciblés. En 2022, Meta a publié NLLB-200, un modèle de traduction aux poids librement téléchargeables pour tout usage hors commerce, qui prend en charge, selon l’entreprise, 55 langues africaines « avec des résultats de haute qualité ». Les outils courants en couvraient alors moins de 25. En juin 2024, Google a ajouté 110 langues à son traducteur, dont environ un quart venues d’Afrique.14 La taille aide. L’attention portée à chaque langue décide.
Chaque technique nouvelle a dû apprendre les langues de l’Afrique
L’écart d’aujourd’hui prolonge une longue histoire. Chaque technique de communication a fini par porter les langues africaines, dès que des institutions et des communautés lui en ont donné les moyens. L’écriture en offre le premier chapitre. Le syllabaire né pour noter le guèze sert aujourd’hui à écrire l’amharique et le tigré.
Au sud du Sahara, des lettrés ont écrit leurs langues en caractères arabes, sous la forme dite ajami. Un projet de l’université de Boston, financé par la British Library, vient de numériser 52 415 pages de manuscrits arabes et ajami produits au Fouta‑Djalon, en Guinée, et au Sénégal. Leurs auteurs ont vécu du XVIIIe au XXIe siècle.15
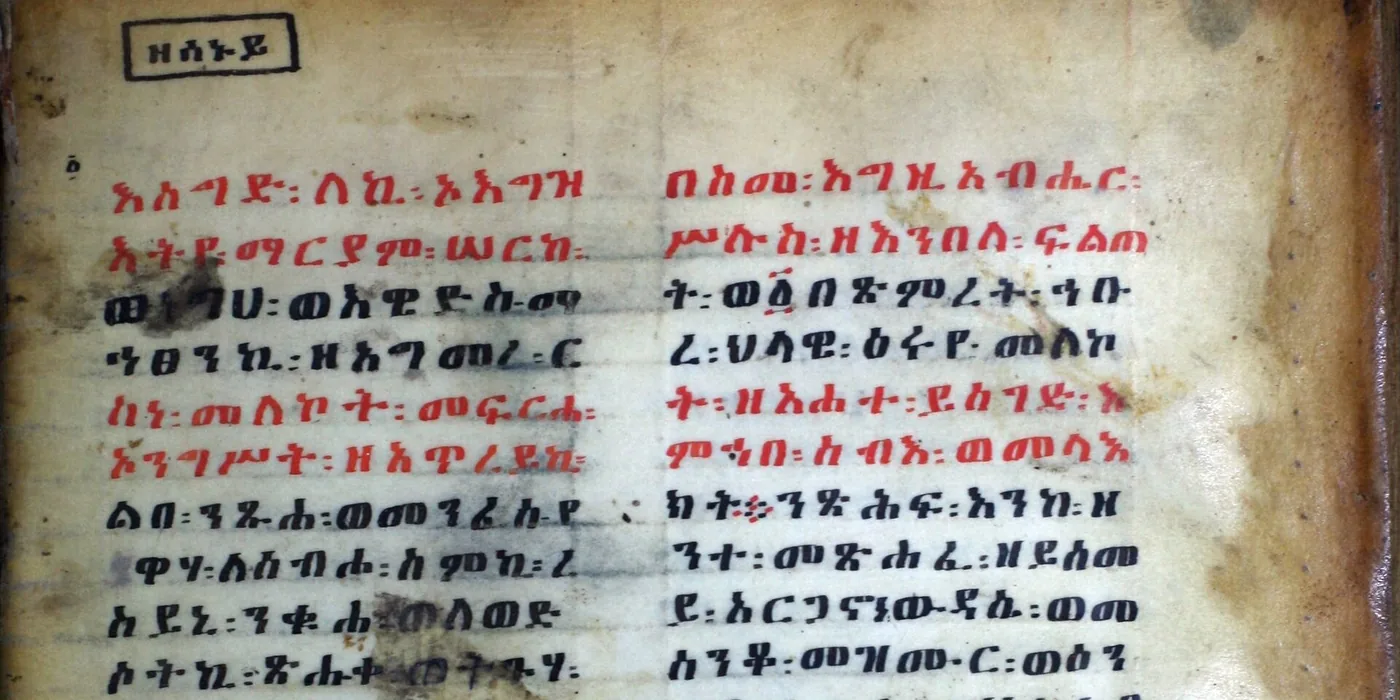
D’autres écritures sont nées sur le continent pour des langues précises. Le vaï apparaît au Libéria dans les années 1830, le bamoun au Cameroun entre 1896 et 1910. Le n’ko date de 1949 pour les langues mandingues, le garay de 1961 pour le wolof, l’adlam de la fin des années 1980 pour le peul.
Chacune est entrée dans les machines par la même porte : son codage dans Unicode, le standard qui attribue un numéro à chaque caractère. L’éthiopien y figure depuis 1999, le tifinagh depuis 2005, le n’ko depuis 2006, le vaï depuis 2008, le bamoun depuis 2009, l’adlam depuis 2016 et le garay depuis 2024.16 Le n’ko dispose aujourd’hui de sa propre édition de Wikipédia, forte de 1 622 articles.
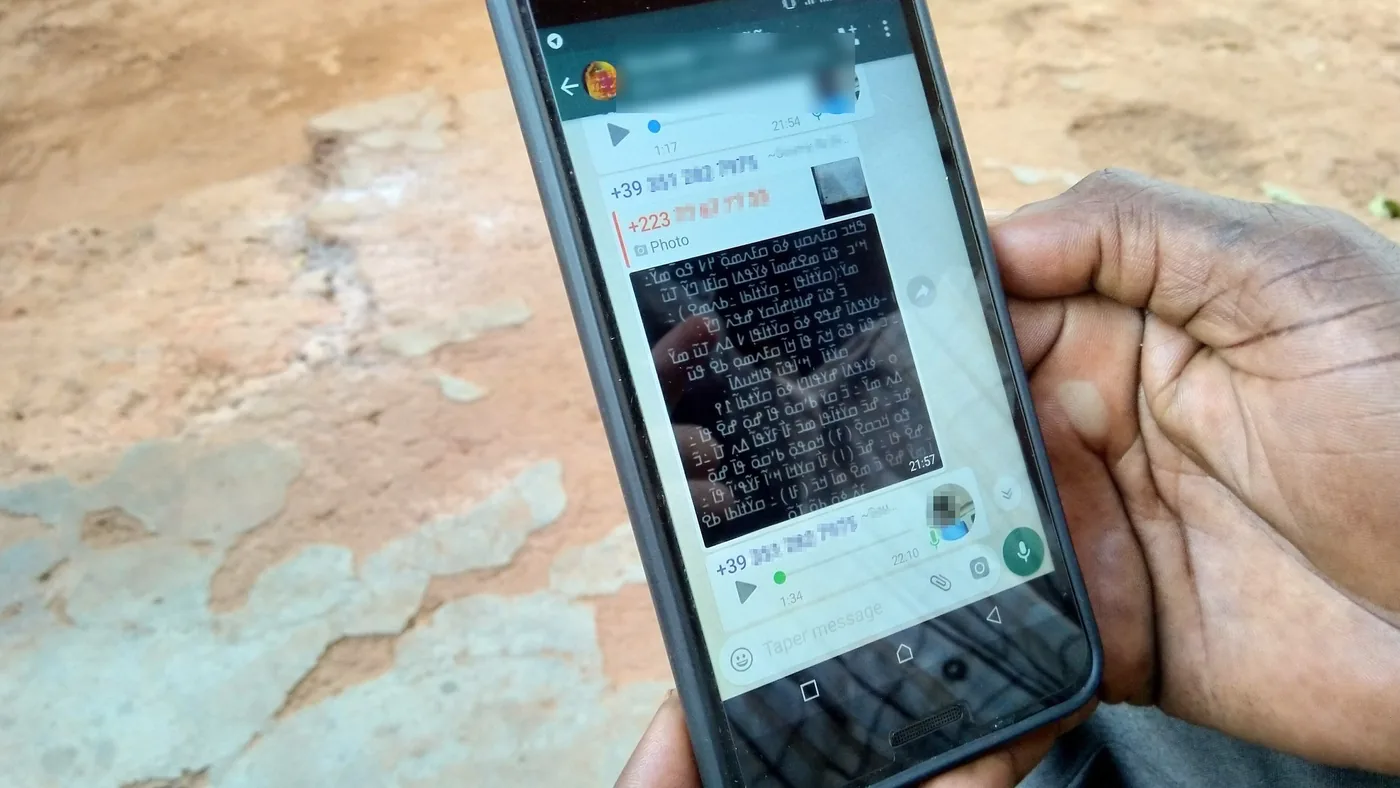
Les politiques linguistiques ont pesé autant que les techniques. Dès 1963, la Charte de l’Organisation de l’unité africaine retenait comme langues de travail, « si possible », des langues africaines, avec l’anglais et le français ; l’arabe et le portugais s’y sont ajoutés par la suite.17 La Constitution sud-africaine de 1996 reconnaissait onze langues officielles, et la langue des signes sud-africaine est devenue la douzième en 2026. Le texte constate « l’usage et le statut historiquement diminués » des langues autochtones, que l’État doit élever par des mesures « pratiques et positives ». Le Maroc a fait du tamazight une langue officielle de l’État dans sa Constitution de 2011.18
En 2003 déjà, l’UNESCO recommandait que toutes les cultures puissent accéder au cyberespace dans toutes les langues, y compris les langues autochtones.19 L’intelligence artificielle repose la question à une échelle supérieure.
Une langue gagne une technique quand une institution ou une communauté la code, l’enseigne ou l’exige.
On objectera que cette histoire penche aussi de l’autre côté. Les langues européennes héritées de la colonisation gardent l’école, l’administration et l’imprimé, et le marché favorise les grandes langues. Nous lisons dans les chiffres du Web la trace de cet héritage. L’histoire dessine pourtant une tendance nette : une langue gagne une technique quand une institution ou une communauté la code, l’enseigne ou l’exige. La technique fournit l’outil. Les États, les écoles et les communautés de locuteurs en décident l’usage.
Les données se construisent, et l’Afrique a commencé
Le constat appelle une réponse par les données, et des Africains la construisent déjà. Le kinyarwanda en donne la démonstration la plus nette (figure 3). Dans la version 27.0 de Common Voice, la base de voix lancée par Mozilla, il réunit 2 001,7 heures de voix validées au 11 septembre 2026, au quatrième rang des 295 langues de la base, devant le français. Le haoussa, parlé par 77 millions de personnes, en compte 4,35.20
Cette avance a une histoire. Après un hackathon organisé à Kigali par Mozilla et l’agence allemande de coopération GIZ, la jeune entreprise rwandaise Digital Umuganda a mobilisé des contributeurs en s’appuyant sur l’umuganda, l’idée rwandaise de coopération communautaire. En septembre 2020, elle avait recueilli 1 211 heures de kinyarwanda auprès de plus de 420 personnes. Elle a ensuite développé avec la GIZ et l’agence rwandaise RISA l’assistant Mbaza, qui délivrait des informations sur la covid-19 en kinyarwanda par un menu téléphonique, ses fonctions vocales étant en préparation.21 Une base publique, une entreprise locale, un partenaire de coopération et une tradition collective ont changé l’échelle d’une langue en quelques années.
Figure 3
Le kinyarwanda réunit davantage d’heures de voix validées que le français, le haoussa en compte 4,35
Heures d’enregistrements validés dans Common Voice, version 27.0, données arrêtées au 11 septembre 2026
| Langue | Heures validées |
|---|---|
| Anglais | 2 826,80 |
| Kinyarwanda | 2 001,70 |
| Français | 1 108,28 |
| Kabyle | 571,72 |
| Luganda | 436,96 |
| Swahili | 392,20 |
| Oromo | 25,88 |
| Yoruba | 5,96 |
| Haoussa | 4,35 |
| Igbo | 2,85 |
| Amharique | 1,94 |
| Zoulou | 0,04 |
| Xhosa | 0,02 |
Lecture : Treize langues retenues ; un enregistrement est validé quand les avis favorables l’emportent après deux écoutes au moins.
Source : Mozilla Common Voice, Scripted Speech 27.0, données arrêtées au 11 septembre 2026 · github.com/common-voice/cv-dataset/blob/main/datasets/scripted-speech/cv-corpus-27.0-2026-09-11.json
D’autres chantiers avancent à l’échelle du continent. Le réseau Masakhane veut renforcer la recherche sur le traitement automatique des langues africaines « pour les Africains, par les Africains » : dès 2020, il publiait des bancs d’essai de traduction pour plus de trente langues. Le Lacuna Fund finance des jeux de données conçus et détenus localement, ouverts à tous ; 25 des 31 jeux de son catalogue linguistique nomment une langue ou une région africaine.22
La propriété des données pose la question la plus lourde. Des voix et des textes donnés par des volontaires africains nourriront d’abord les produits de grandes entreprises étrangères. Le risque est réel, et des juristes africains y répondent par le droit. La licence NOODL, élaborée en consultation avec des communautés de locuteurs, reprend les licences Creative Commons. Elle module les obligations selon le contexte géographique et économique de l’utilisateur, avec des conditions préférentielles pour les pays du Sud.
Elle a d’abord servi à un corpus de parole en dholuo, au Kenya. En avril 2026, elle restait une expérience : une licence appliquée à un seul jeu de données.23 Fermer les données tiendrait ces langues à l’écart des modèles. Les ouvrir à tous aux mêmes conditions profiterait d’abord aux mieux équipés. Entre les deux se dessine un choix de gouvernance, que les institutions africaines peuvent trancher.
Les textes fixent déjà une direction. Adoptée à Accra en juillet 2024, la Stratégie continentale de l’Union africaine pour l’intelligence artificielle constate que le manque de données freine la reconnaissance vocale dans les langues africaines. Elle juge que la prolifération de modèles génératifs en anglais « menace les systèmes culturels africains et la diversité linguistique », et recommande d’investir dans les langues « locales et autochtones ».24 La Recommandation de l’UNESCO sur l’éthique de l’intelligence artificielle (2021) invite les États à examiner l’effet de la traduction automatique et des assistants vocaux sur les langues, jusqu’au risque de disparition des langues menacées.25
À nos yeux, le verrou tient désormais aux institutions plus qu’à la technique. La technique apportera des micros et des modèles capables d’apprendre à partir de peu d’exemples. Les voix et les textes viendront des locuteurs. Le financement dans la durée, la conservation des archives et le choix des licences reviennent aux institutions. La formation de nouveaux auteurs revient à l’école.
Ce que nous recommandons
Financer des corpus publics
Chaque État finance des corpus ouverts de textes et de voix dans ses langues, sous une licence choisie avec les locuteurs ; l’Académie africaine des langues en coordonne les normes.
Évaluer avant de déployer
Tout système d’intelligence artificielle d’un service public est évalué, résultats publiés, dans les langues de ses usagers, sur des bancs d’essai comme IrokoBench.
Numériser l’archive écrite et sonore
Bibliothèques, universités et radios numérisent et transcrivent leurs fonds en langues africaines, des manuscrits ajami et guèzes aux archives radiophoniques.
Reconnaître la collecte de données
Les universités créditent les étudiantes et étudiants qui enregistrent ou annotent des données dans leurs langues, et les rémunèrent quand ces données servent un produit.
Écrire, enregistrer et exiger dans ses langues
Les jeunes écrivent et enregistrent dans leurs langues sur Wikipédia et Common Voice, rejoignent Masakhane et réclament des services dans ces langues.
Sources
Données consultées le 20 novembre 2026 ; citations de l’anglais traduites par nos soins.
- Adelani, D. I., et al. (2025). IrokoBench. NAACL 2025.
- Afrique du Sud (1996, 2023), Constitution et dix-huitième modification ; Maroc (2011), Constitution.
- Afrobarometer (2026). Dépêche n° 1173, 27 avril 2026.
- Assemblée générale des Nations unies (2024). Résolution 78/312.
- Banque mondiale (2026). World Development Indicators.
- Boston University (2026). Readers in Ajami, 27 mai 2026.
- Brown, T., et al. (2020). Language Models are Few‑Shot Learners.
- Common Crawl (2026). Statistiques des langues, CC-MAIN-2026-43.
- Google (2024). 110 new languages are coming to Google Translate.
- Hammarström, H., et al. (2026). Glottolog 5.4.
- Kudugunta, S., et al. (2023). MADLAD-400. arXiv:2309.04662.
- Lacuna Fund (2026). Language Datasets.
- Llama Team, AI @ Meta (2024). The Llama 3 Herd of Models.
- Meta AI (2022). Annonce de NLLB-200.
- Mozilla (2020, 2021, 2026). Billets ; Common Voice, Scripted Speech 27.0.
- Nekoto, W., et al. (2020). Findings of EMNLP 2020, p. 2144-2160.
- Ojo, J., et al. (2025). AfroBench. Findings of ACL 2025.
- Okorie, C. I., et Omino, M. (2025). Law, Technology and Humans, 7 (3).
- OpenAI (2025). Introducing GPT-4.1 in the API, 14 avril 2025.
- Open Future (2026). NOODL. An experiment in equitable data licensing.
- UIT (2025). Facts and Figures 2025 ; rapport régional Afrique.
- UNESCO (2003, 2016, 2021). Recommandations ; document d’orientation 24.
- Unicode Consortium (2026). The Unicode Standard 18.0, chapitre 19.
- Union africaine (2024). Continental Artificial Intelligence Strategy ; OUA (1963). Charte.
- Wikimedia (2026). Statistiques des éditions de Wikipédia.
Télécharger
Version 1.1 · · CC BY 4.0
Citer cette note
YouthShare Initiatives (2026). Apprendre à la machine les langues de l’Afrique : L’écart se mesure dans les données, et les données se construisent. Note de preuves, The Digital Palaver, version 1.1. YouthShare Initiatives. https://youthshareinitiatives.org/fr/publications/apprendre-a-la-machine-les-langues-de-lafrique
Licence
CC BY 4.0
Texte et graphiques sous licence Creative Commons Attribution 4.0 International (CC BY 4.0).